Stable Diffusion をローカル環境で動かす
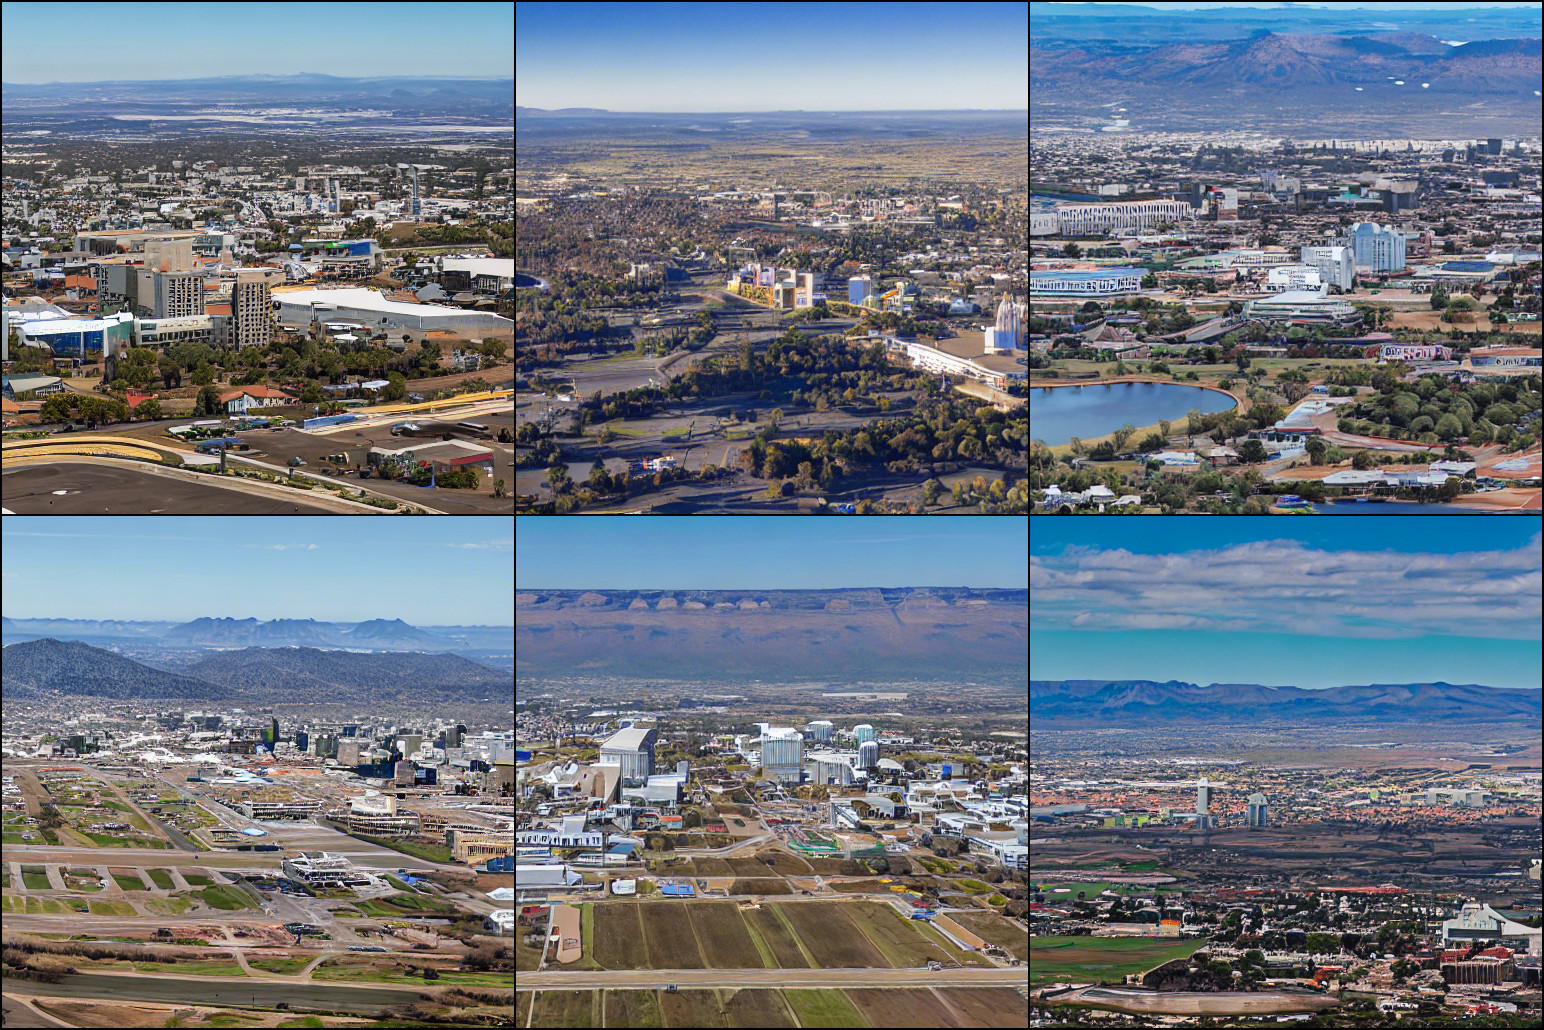
 Stable Diffusion はテキスト入力に基づく画像生成モデルです。
文章を入力するとそれっぽいイメージを作成することができます。流行しているAIによる画像作成ですが、その実装のソースコードと訓練モデルは公開されていたりします。
これを入手するとお使いのデスクトップ PC でも画像生成を試すことが可能となります (ラップトップで動かすのはかなり厳しいです)。
具体的には VRAM 8GB 以上のグラフィックカードなしに運用するのは困難です。公式見解では 16GB 以上の RAM と 4GB 以上の VRAM が必要容量となっていますが、この構成では工夫しないと実行途中に killed という表示を残して終了します。
実行前に構成を確認してください。私の環境は以下のようになります。
$ grep -i pretty /etc/os-release
PRETTY_NAME="Ubuntu 22.04.3 LTS"

$ python -V
Python 3.10.9

$ conda -V
conda 23.3.1
ソースコードは以下に公開されていますので、リポジトリをクローンしてくれば良いです。 Python3 実行環境とライブラリのインストールは必要となりますが、Stable Diffusion 自体はインストールせずとも利用できます。
GitHub - CompVis/stable-diffusion: A latent text-to-image diffusion model https://github.com/CompVis/stable-diffusion
$ git clone https://github.com/CompVis/stable-diffusion.git
$ cd stable-diffusion
$ git log | head -n 1
commit cf1d67a6fd5ea1aa600c4df58e5b47da45f6bdbf
必要なのはソースコードとモデルデータとライブラリです。 モデルデータを非常に大雑把に言い換えると画像の特徴や傾向を表現する関数みたいなものです。一番分かりやすい例は迷惑メールを判別するフィルターでしょう。 膨大の数の画像データから特徴を学習させてモデルを作成します。 Stable Diffusion では こちらに掲載されているファイル群がそれにあたります。 これらのファイルをダウンロードして、実行時に参照できるようにしています。もちろん、余裕があるなら自作しても構いません。 サンプルスクリプトの参照の項に示されている以下のコマンドです。
$ ln -s models/ldm/stable-diffusion-v1/sd-v1-1.ckpt models/ldm/stable-diffusion-v1/model.ckpt要するに生成時に使用するモデルとして models/ldm/stable-diffusion-v1/model.ckpt を読み込むので、シンボリックリンクを作成してファイルを参照しています。この過程は必ずしも必要ではありません。 実行時に --ckpt オプションでファイルのパスを指定してやれば同じことができるので、複数のモデルを使い分ける場合には個別に指定したほうが分かりやすいです。 むしろ環境によっては config ファイルを参照できずにプロセスが異常終了することがあるので --config stable-diffusion/configs/stable-diffusion/v2-inference.yaml といった具合に一緒に明示的にパスを引数で渡したほうがトラブルが少ないかもしれません。 ソースコードとモデルの準備が終わりましたら、必要なライブラリのインストールを行います。
$ conda env create -f environment.yaml
$ conda activate ldm

$ conda install pytorch torchvision -c pytorch
$ pip install transformers==4.19.2 diffusers invisible-watermark
$ pip install -e .
やることはこれだけのはずですが、実行するとあれが足りない、これがないと言った具合にエラー表示がたくさん出てきます。 具体的には以下のような例があります。これらは2つ以上の環境で再現されたものです。
File "./scripts/txt2img.py", line 2, in import cv2 ModuleNotFoundError: No module named 'cv2'
File "./scripts/txt2img.py", line 5, in from omegaconf import OmegaConf ModuleNotFoundError: No module named 'omegaconf'
/scripts/txt2img.py", line 9, in from einops import rearrange ModuleNotFoundError: No module named 'einops'
/scripts/txt2img.py", line 10, in from torchvision.utils import make_grid ModuleNotFoundError: No module named 'torchvision'
/scripts/txt2img.py", line 11, in from pytorch_lightning import seed_everything ModuleNotFoundError: No module named 'pytorch_lightning'
/scripts/txt2img.py", line 14, in from imwatermark import WatermarkEncoder ModuleNotFoundError: No module named 'imwatermark'
仕方がないのでそれぞれ個別にインストールして、エラー表示の有無を確認します。
$ pip install opencv-python
$ pip install omegaconf
$ pip install einops
$ pip install torchvision
$ pip install invisible-watermark
ここまで正常にインストールできましたら準備完了です。 サンプルスクリプトにお好きな入力文を入れて生成してみます。
$ python ./scripts/txt2img.py --prompt "an aerial view of Springfield with table mountain in the background" --plms --config ./configs/stable-diffusion/v1-inference.yaml --ckpt /media/turnip2/datasets/ckpt/sd-v1-1.ckpt --outdir /media/turnip2/generated/stable-diffusion
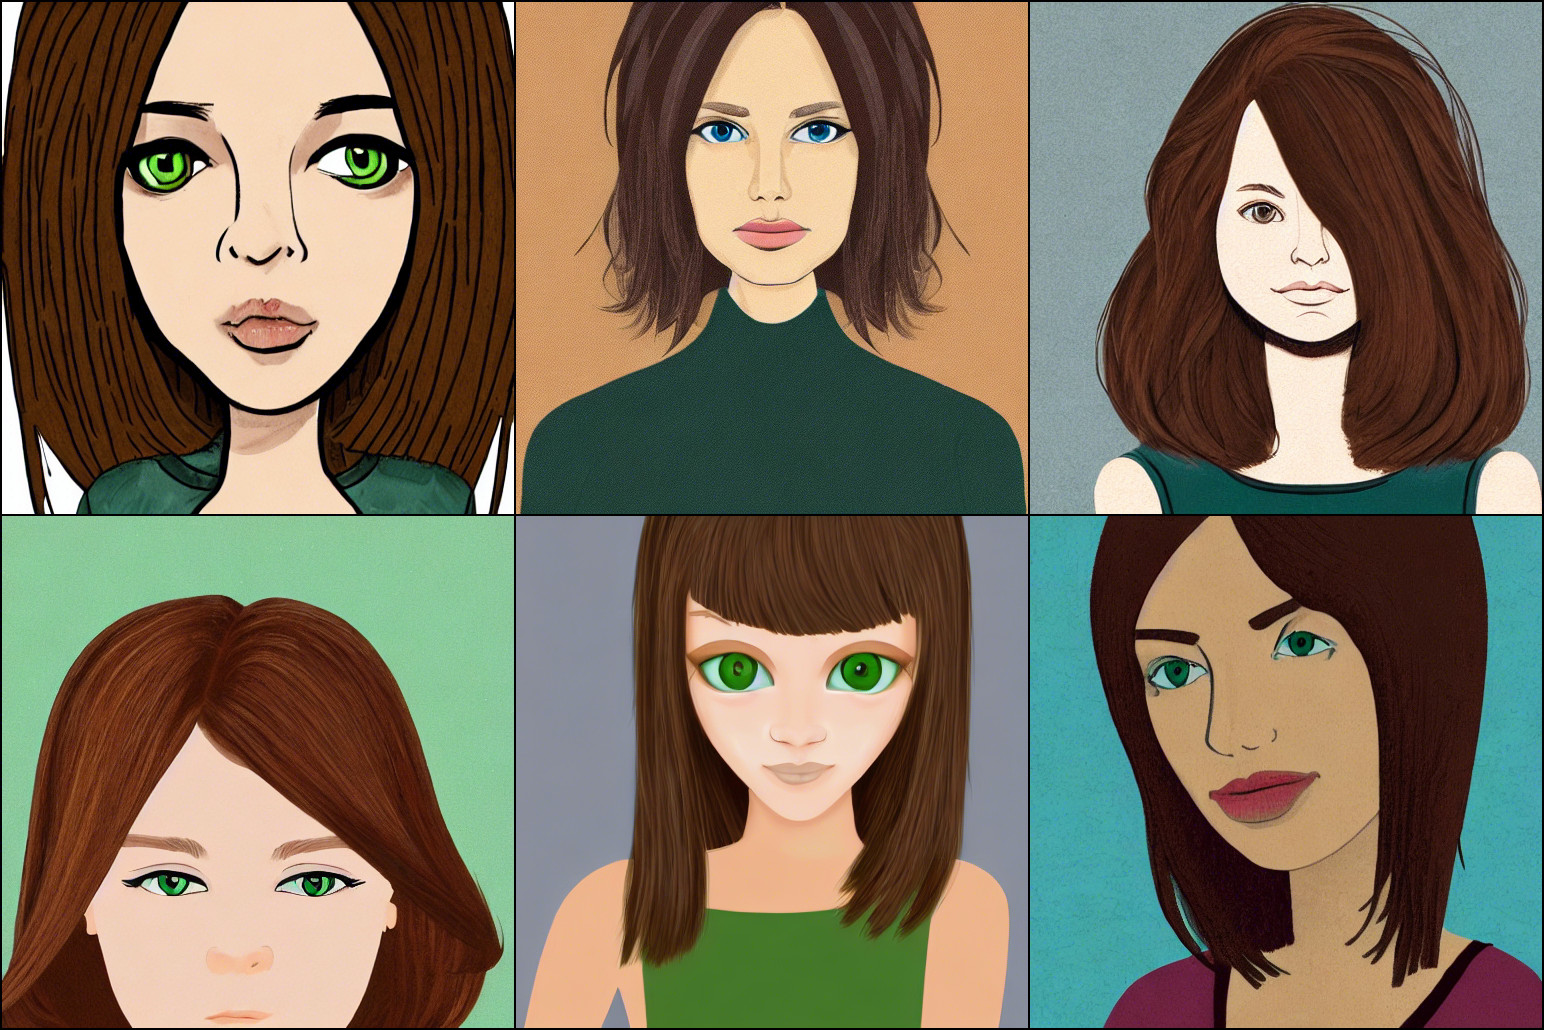
 モデルを変更して作成できることを確認します。
$ python ./scripts/txt2img.py --prompt "an illustration of a brown-haired girl with wide green eyes and a mid-length haircut" --plms --config ./configs/stable-diffusion/v1-inference.yaml --ckpt /media/turnip2/datasets/ckpt/sd-v1-4.ckpt --outdir /media/turnip2/generated/stable-diffusion
ローカル環境が高スペックだと話は簡単です。ほんの数分以内に画像が生成されます。
必要スペックの下限に近いラップトップでは、生成画像のサイズを小さくしたり、GPU を使用せずに CPU だけで実行したり、いろいろ試行錯誤して苦労した挙句にあと一歩のところでうまく行かなかったりします。
$ lspci | grep VGA
00:02.0 VGA compatible controller: Intel Corporation TigerLake-LP GT2 [Iris Xe Graphics] (rev 03)

$ free -h
               total        used        free      shared  buff/cache   available
Mem:            15Gi       2.1Gi       9.3Gi       632Mi       3.9Gi        12Gi
Swap:          2.0Gi          0B       2.0Gi
その試みは生産的ではないので、素直に生成用のマシンを用意するか、Google Colaboratory に課金しましょう。
Google Drive にモデルデータを置いておいて Colab から参照するのが一番簡単です。
from google.colab import auth
from google.colab import drive
auth.authenticate_user()
drive.mount('/content/drive')
環境構築はローカル環境と変わりませんが、torchmetrics, torchvision, torchtext, torchdata あたりはバージョンを指定して再インストールしてやらないと正常に動作完了しませんでした。
機械学習環境だけあって大体のライブラリは予めインストールされていましたが、相変わらずいくつかのライブラリは不足していたので明示的にインストールする必要がありました。
!pip install diffusers
!pip install omegaconf
!pip install invisible-watermark
!pip install einops
!pip install taming-transformers-rom1504
!pip install clip
!pip install kornia
Comments
No comments yet. Leave the first one.
Leave a comment